Observability & SRE
Visibilidad completa de tu plataforma, del código a la infra
Métricas, logs y traces unificados. Detecta y resuelve antes de que el cliente lo note. Stack abierto, sin lock-in.
MTTR más bajo, cero puntos ciegos
El problema
- Cuando algo se rompe, vuelas a ciegas: no sabes dónde ni por qué.
- Tu tiempo de resolución (MTTR) es alto y el cliente se entera antes que tú.
- Tienes mil alertas y ninguna te dice qué importa de verdad.
- No puedes rastrear una request de punta a punta para entender la latencia.
Qué incluye
- Stack de observabilidad unificado: métricas, logs y traces en un solo lugar.
- Dashboards accionables por servicio, equipo y negocio.
- SLOs, SLIs y alerting que avisa de lo que importa, sin ruido.
- Distributed tracing con OpenTelemetry, del código a la infraestructura.
- Runbooks y prácticas SRE para que el on-call no sea un caos.
Stack abierto, sin lock-in
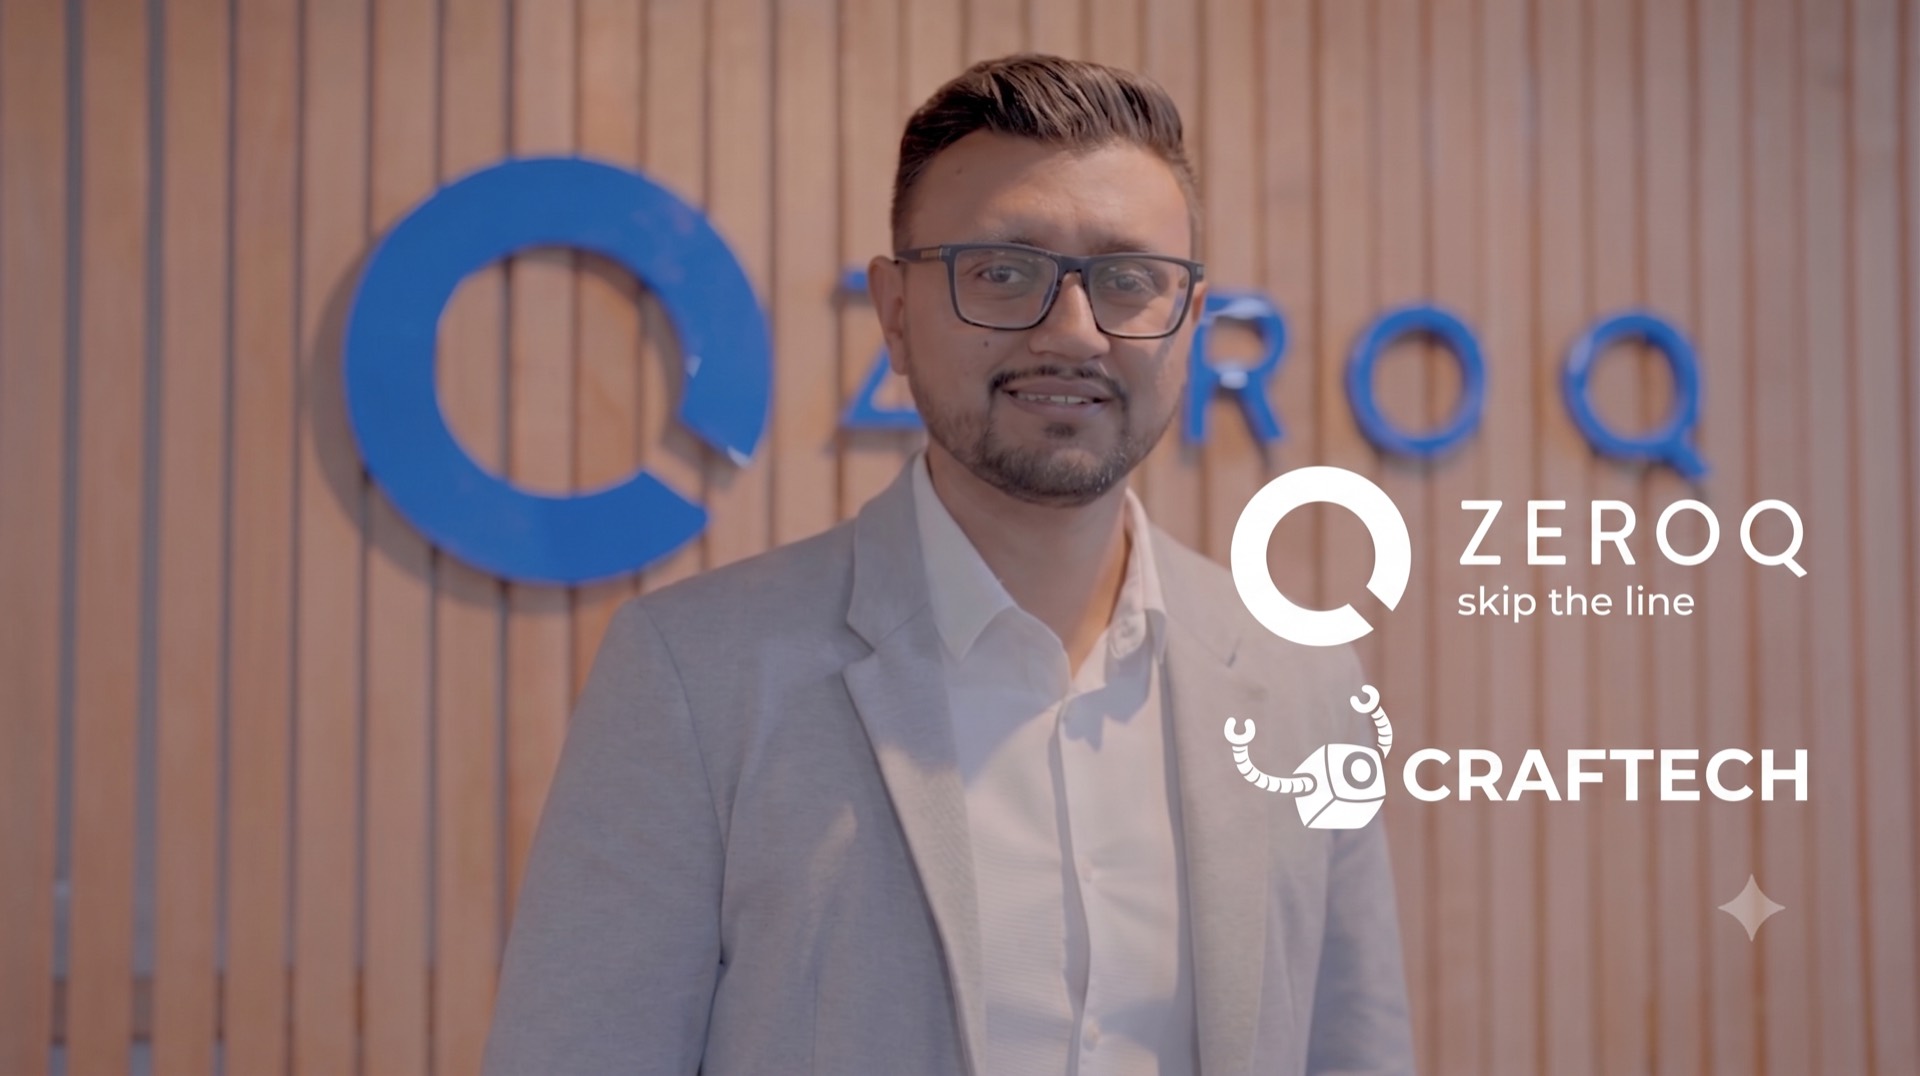
Trabajamos con Prometheus, Grafana, Loki, Thanos y OpenTelemetry: estándares abiertos que no te atan a un vendor. Es el mismo stack con el que le dimos visibilidad en tiempo real a ZeroQ tras su migración.
Cómo trabajamos
Discovery
Relevamos qué visibilidad tienes hoy y dónde están tus puntos ciegos y tus incidentes recurrentes.
Plan & Quote
Diseñamos el stack de observabilidad y el set de SLOs/alertas, con alcance y precio claros.
Ejecución
Instrumentamos tu plataforma, montamos dashboards y configuramos alerting útil. Validamos con incidentes reales.
Hand-off & MSP
Capacitamos a tu equipo en SRE y on-call. Podemos seguir operando la observabilidad como parte de tu MSP.
Stack & tecnologías
Credencial AWS
AWS Well-Architected Partner Program
El AWS Well-Architected Partner Program reconoce nuestra capacidad para evaluar y mejorar arquitecturas en AWS según los seis pilares del framework: excelencia operativa, seguridad, confiabilidad, eficiencia de rendimiento, optimización de costos y sostenibilidad.
Combinamos revisiones técnicas con visión de negocio para detectar riesgos, priorizar mejoras y definir un roadmap accionable para cada entorno.
Este programa atraviesa todo lo que hacemos: cada migración, modernización o proyecto de IA se construye sobre las mismas buenas prácticas que AWS audita.
MTTR más bajo · visibilidad en tiempo real
Preguntas frecuentes
¿Me atan a una herramienta de observabilidad cara?
No. Usamos estándares abiertos (Prometheus, Grafana, Loki, OpenTelemetry). Sin licencias por host que escalan con tu factura.
¿Qué es un SLO y por qué lo necesito?
Un Service Level Objective define cuán confiable tiene que ser tu servicio. Te permite alertar sobre lo que afecta al cliente, en vez de ahogarte en métricas sin contexto.
¿Sirve si ya uso CloudWatch?
Sí. Integramos CloudWatch con el resto del stack para que tengas una vista unificada, no silos.
¿Tienen un caso real?
ZeroQ: tras migrar a AWS, montamos Grafana, Loki, Prometheus y Thanos para darle visibilidad en tiempo real y menor latencia.